基于Group MCP Logistic模型的个人信用评价分析
2015-08-10 14:35:10胡小宁何晓群马学俊
现代管理科学
2015年8期
胡小宁 何晓群 马学俊
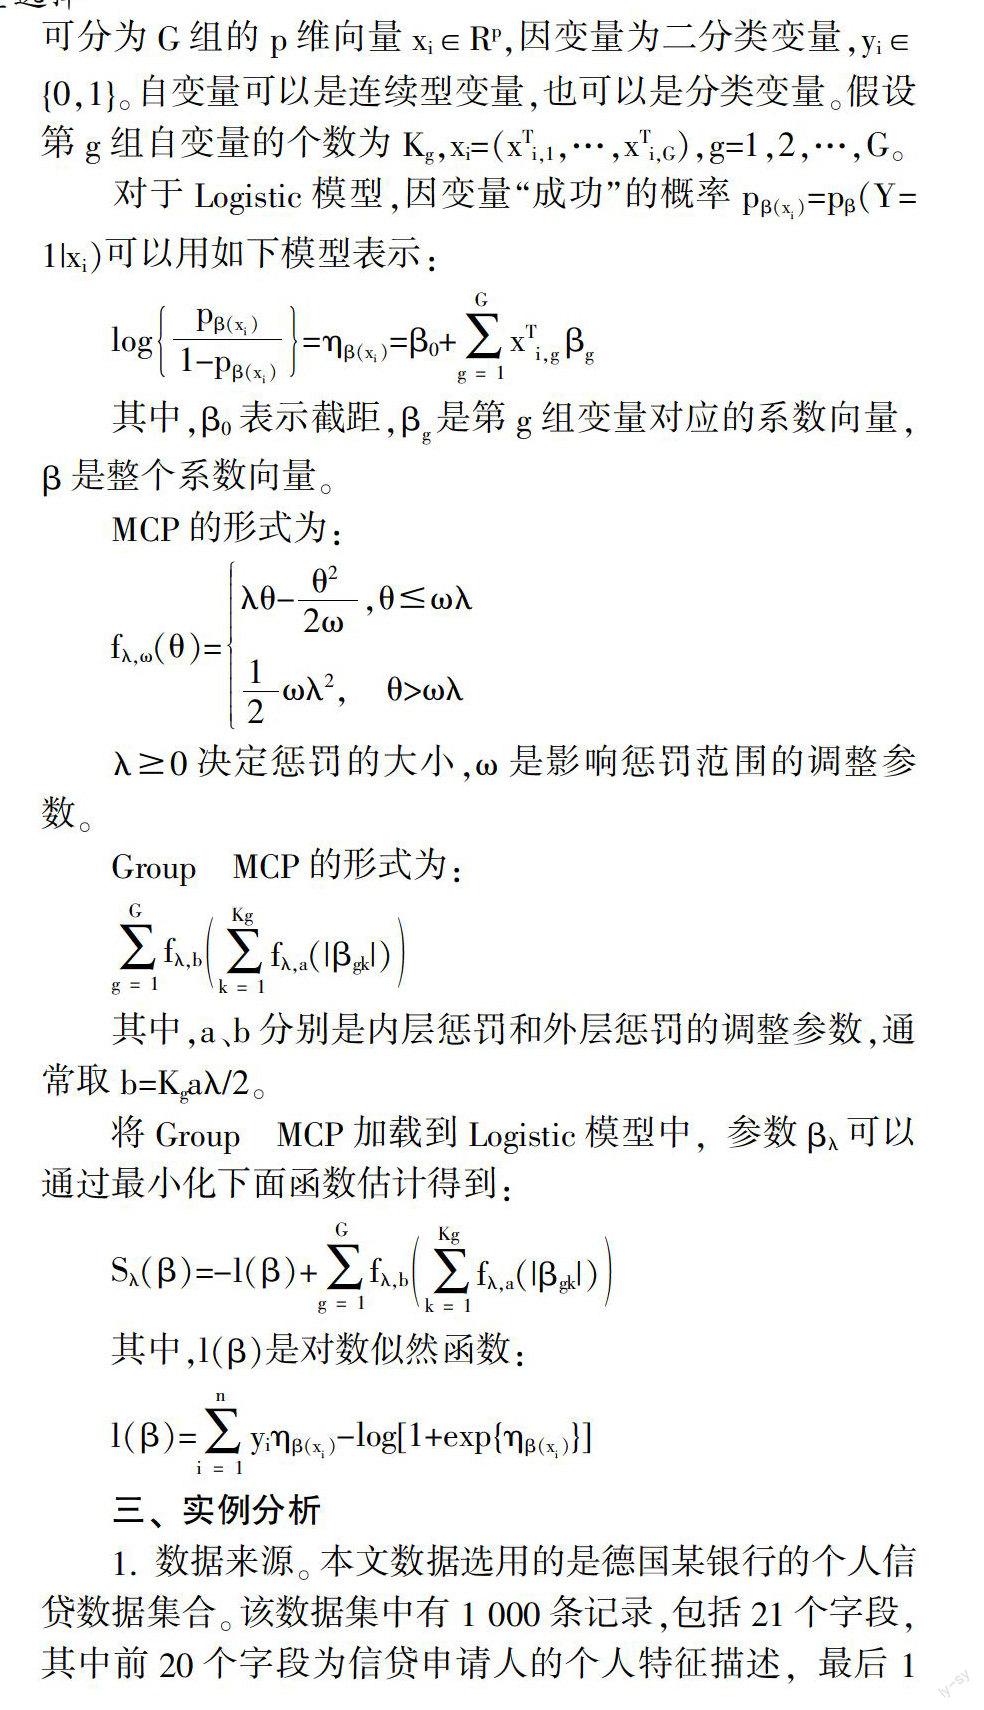
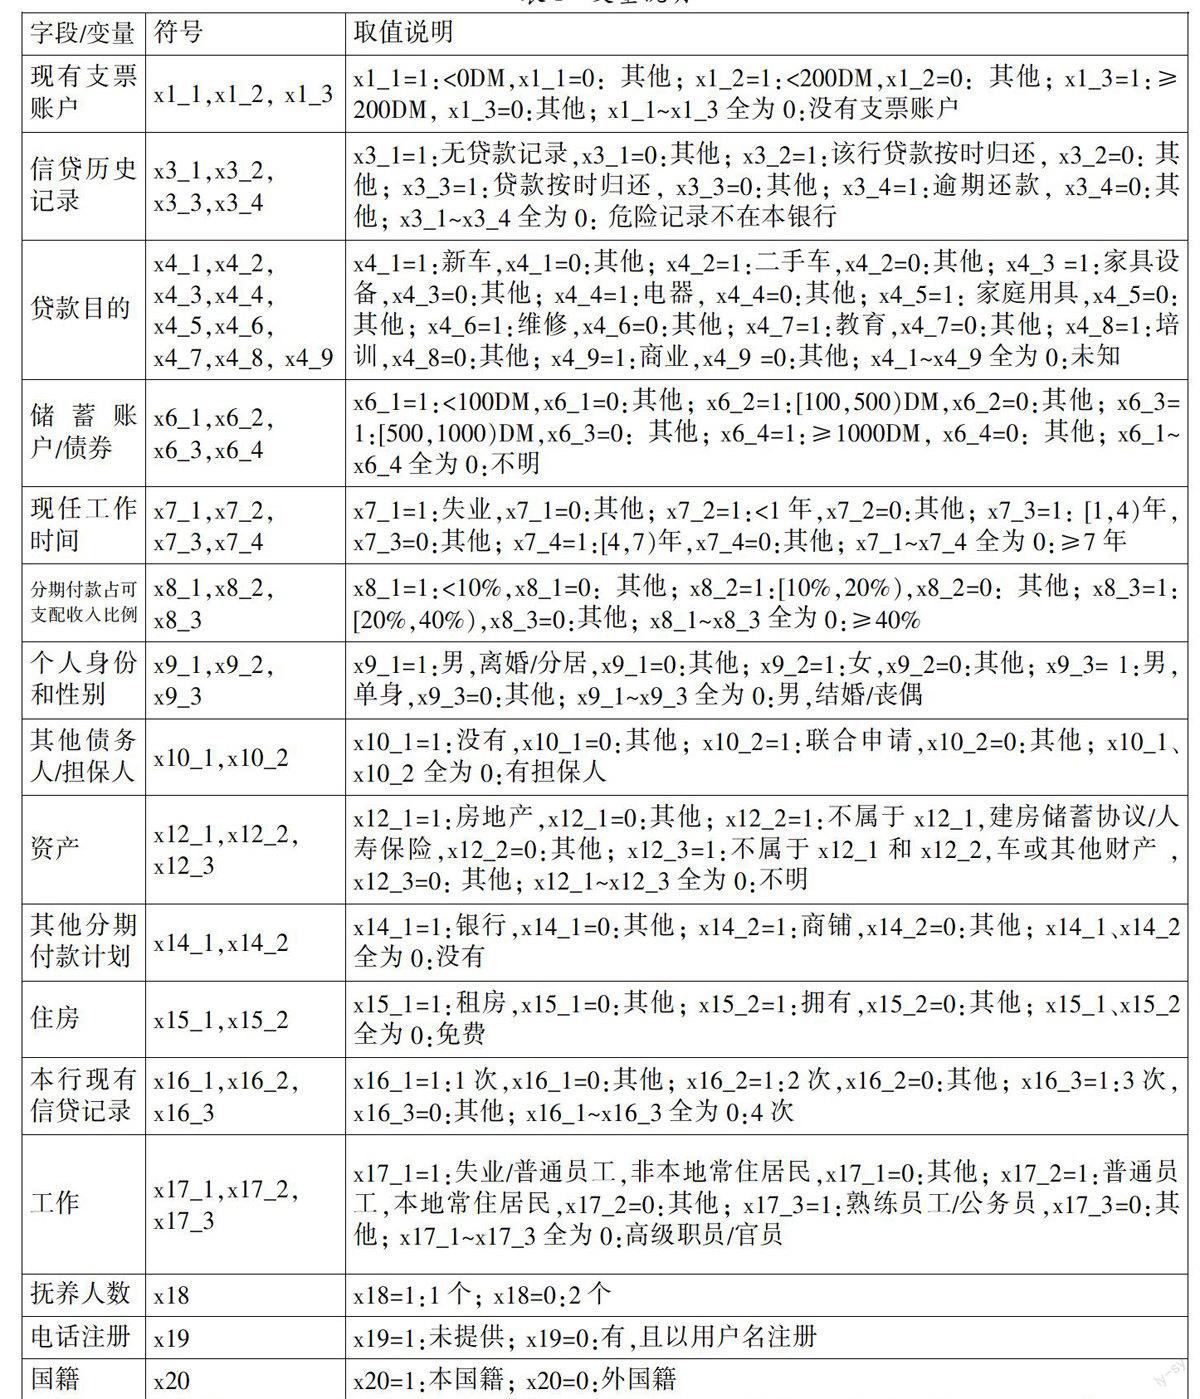
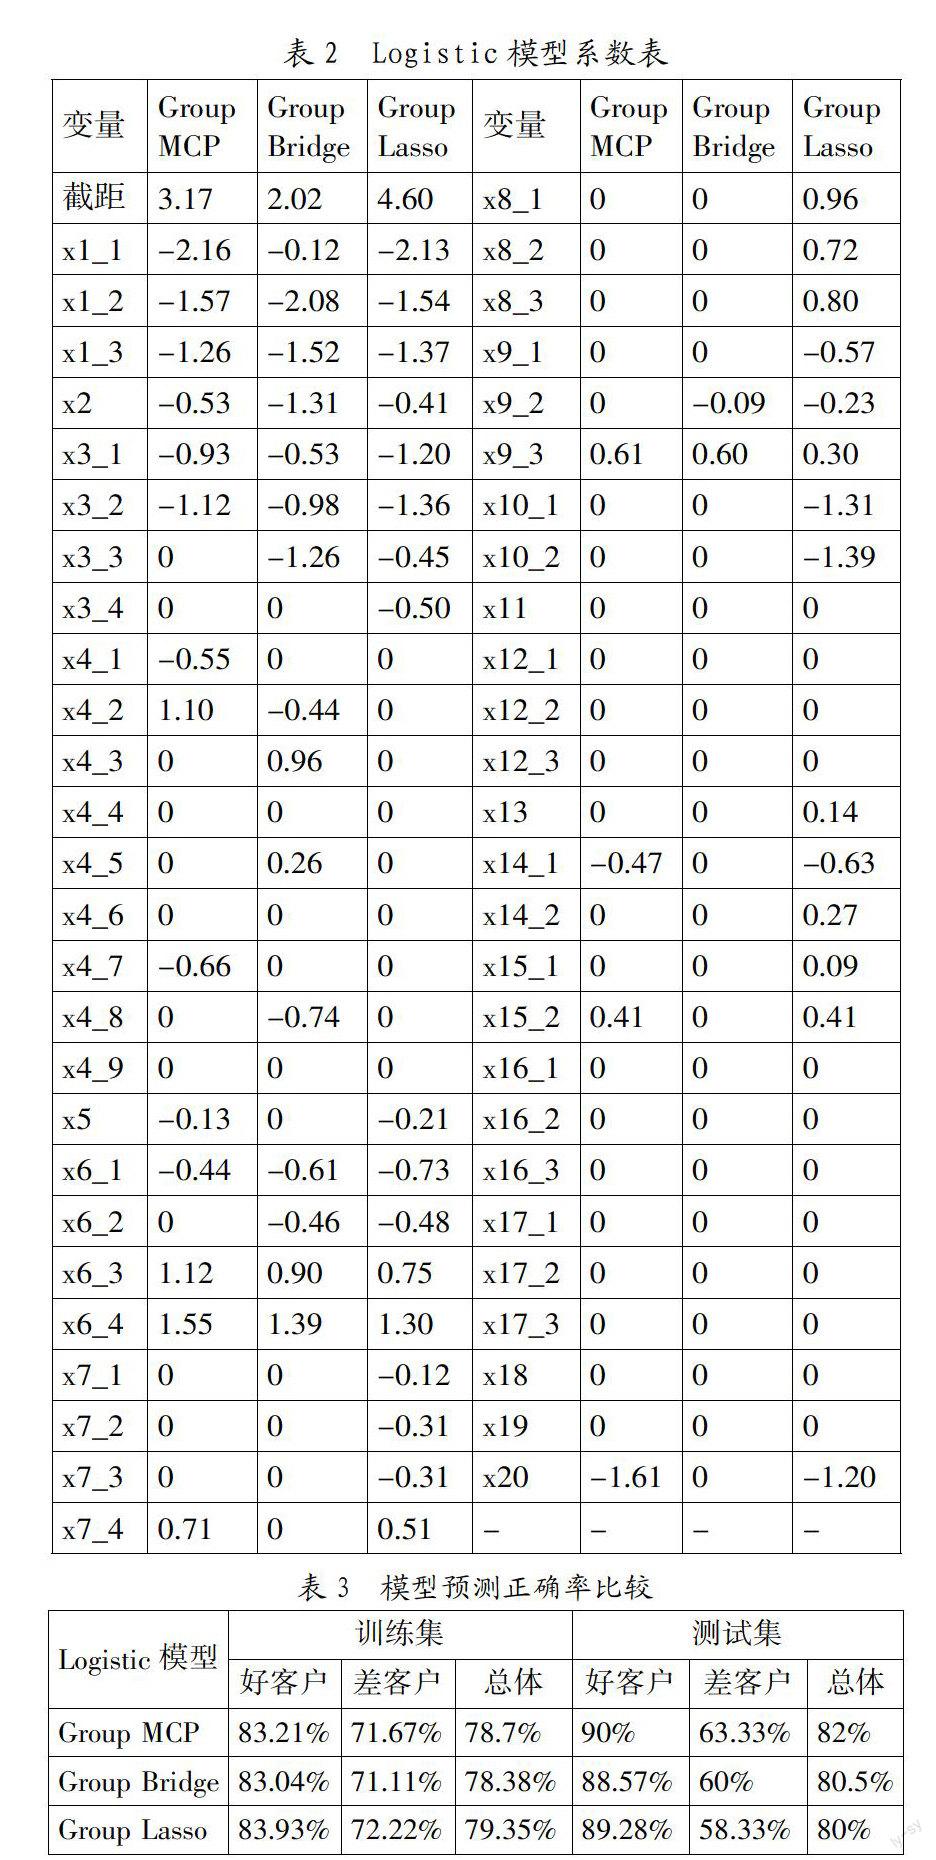
摘要:在利用Logistic模型分析个人信用评价问题时,需要进行变量选择。Group MCP不仅可以将相关变量以组为单位进行变量选择,还可以对组内变量进行选择。文章根据个人信贷数据,建立了Group MCP Logistic模型,并与Group Lasso、Group Bridge所得的结果进行比较,综合考虑模型复杂度和预测正确率,发现根据Group MCP建立的模型效果是最优的。
关键词:Group MCP;Logistic模型;个人信用评价;变量选择
一、 引言
个人消费信贷在我国迅速发展,对拉动经济增长起到了一定的促进作用。但其中也隐藏着很大的潜在风险,即信贷资产不能及时有效地收回。因此,急需建立完善的个人信用评价体系,从而降低信贷风险。个人信用评价的核心是建立不同客户的信用评价模型,根据信用评价模型对信贷申请人进行评分,从而决定是否给予贷款。
个人信用评价分析中,应用最广泛的方法有统计分析和机器学习两类,前者在模型稳健性和可解释性上有很大的优势。统计分析方法中,学者最关注的是Logistic模型,其计算方法简单、预测准确率高、变量解释能力强。但当Logistic模型涉及的变量很多时,直接使用也存在多重共线性和计算复杂度等问题。因此,变量选择是个人信用评价问题的重点和难点。
传统的变量选择方法有最优子集法和逐步回归法,但这些方法计算量大,且不稳定,当数据有微小变化时,可能得到完全不同的模型,其结果往往是局部最优解,并非全局最优解,尤其当变量个数大于样本量时,方法失效。……
登录APP查看全文