基于Python的动态网页评价爬虫算法
2016-04-29 00:44:03夏火松李保国
软件工程
2016年2期
夏火松 李保国
摘 要:在大数据获取中面临着如何采集动态评论网页的问题,这篇论文使用静态网页信息构造动态链接,提出了基于Python的动态网页评论爬虫算法。在此基础上实现了评论收集程序。最后将它与通用爬虫算法进行比较,证实了该算法具有针对性强、数据采集速度快、易嵌入开发、简单等优点,为不善于编程的新闻、文学、管理等学科的研究者提供了快速获取评论信息的方法。
关键词:Python语言;静态地址;动态链接;动态网页评论;爬虫算法
中图分类号:TP312 文献标识码:A
1 引言(Introduction)
大数据具有数据体量巨大(Volume)、数据类型繁多(Variety)、价值密度低(Value)、处理速度快(Velocity)的特点。在大数据获取中面临的一个数据源问题为:如何获取大量的动态评论数据?Python是一门独立的语言,可以直接操作数据库,便于对大规模数据的操作与分析[1]。而且,由于Python包含结巴分词等程序包,可以直接进行分词,适宜于自然语言处理[2]。
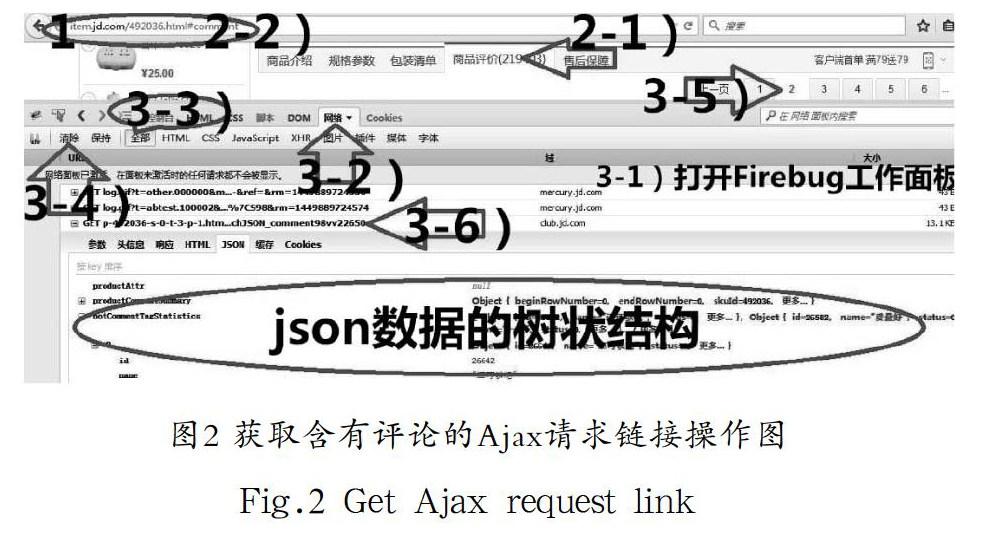
现在很多网页通过Ajax动态请求、异步刷新生成数据[3]。Python由于先天局限,它爬取静态网页的方法难于直接提取动态网页。而爬取动态网页的方法虽然有很多,但便于新闻学、语言学、管理等学科的研究者应用的方法却很少。所以这篇论文研究如何用Python语言爬取Ajax动态生成的评论数据。
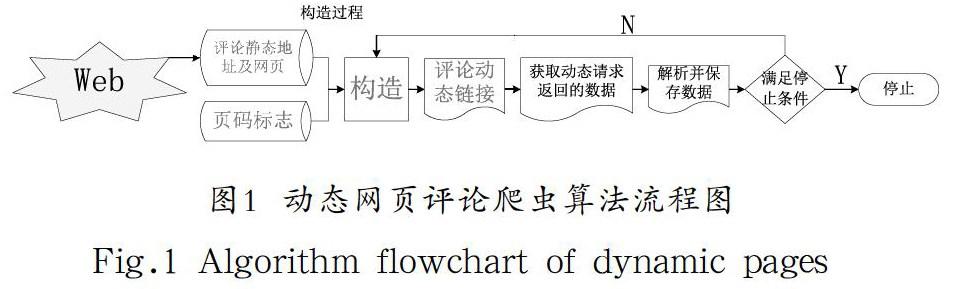
这篇论文延续前人的方法,通过静态网址信息构造动态链接,并增加了翻页的部分,把各种商品、新闻、社交网站、TV等动态网页评论的爬取方法归结为一套抽象的爬虫算法流程图。在此基础上实现了商品评论收集程序[4]。……
登录APP查看全文