配网工程项目词库创建及分词探索
2016-05-30 07:21:20张文露谭骞章光东
企业技术开发·中旬刊
2016年11期
关键词:文本挖掘
张文露 谭骞 章光东

摘 要:随着国网公司信息系统的完善和业务数据的积累,公司各业务部门开展了数据探索和分析,以支撑逐年增加投资、扩大规模的配网工程项目建设工作。但是由于各省市公司的管理模式不同,导致配网工程项目相关数据一致性较差,可用于支撑分析的特征值较少。因此论文基于文本挖掘方法创建符合国网公司特性的工程词库,弥补过往历史数据的缺失和不完整,使历史文本数据能够支撑后续数据分析工作。
关键词:文本挖掘;配网工程;词库创建
中图分类号:TP391 文献标识码:A 文章编号:1006-8937(2016)32-0072-02
1 研究背景
配网工程项目具有项目类型众多、物资使用种类集中的特点,随着国网信息化系统建设的逐渐完善,出现联合数据分析的需求,然而由于各网省公司项目管理水平的差异,配网项目在各网省公司的管理模式不同。
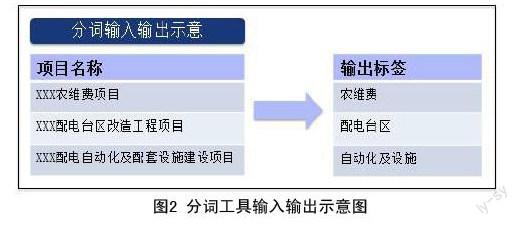
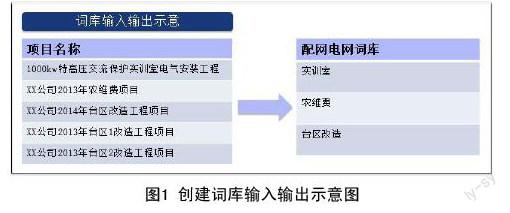
部分省公司按照区县对配网项目进行打包管理,部分省公司则按照单体项目进行管理。但是从整体来看,针对配网工程项目的管理是松散的,直接导致了配网工程项目的可用特征较少,无法配合其他数据,以工程项目为对象进行联合数据分析。但是配网工程项目的命名包含一定规律,可以通过文本挖掘的方法从工程项目名称中提取有效的项目属性特征,以描述工程建设性质和建设内容。然而目前较为成熟的分词函数都依赖于对应的专业词库,即基于一本专业“词典”自动完成名词的分解,所以提取配网工程项目特征标签的首要任务就是构建专业的配网电网词库,以支持后期分词函数的应用,完成对配网工程项目名称的分词。……
登录APP查看全文
猜你喜欢
科技资讯(2017年5期)2017-04-12 15:18:52
电脑知识与技术(2016年33期)2017-03-21 08:13:37
商情(2016年32期)2017-03-04 00:27:28
软件导刊(2016年12期)2017-01-21 15:55:21
电子技术与软件工程(2016年22期)2016-12-26 20:29:58
商(2016年34期)2016-11-24 16:28:51
中国远程教育(2016年9期)2016-11-19 12:26:00
中国中医药图书情报(2016年4期)2016-10-20 23:35:25
湖南师范大学学报·自然科学版(2016年3期)2016-06-25 06:47:25
语文教学之友(2016年5期)2016-06-15 12:15:44