
改进的协同过滤推荐算法
2017-01-13 08:22:08于玉龙王秀芳
中国新通信
2016年22期
于玉龙+王秀芳
【摘要】 协同过滤被广泛应用到个性化推荐中,本文针对传统协同过滤推荐算法准确度不高的问题进行研究,将用户之间共同评分的物品数量作为相似度计算的重要指标,并引入信任度对用户评分进行修正,提高推荐准确度。
【关键词】 协同过滤 信任度 相似度 电影推荐
一、引言
随着互联网的发展,人们很难再海量的数据中快速找到自己需要的资源,很多网站想挖掘用户的偏好向用户推荐他们感兴趣的物品,协同过滤是最常用的推荐技术[1]。推荐技术主要有基于物品的推荐与基于用户的推荐及混合推荐三种。许多研究人员提出了不同的算法来提高推荐可靠性,如采用不同聚类方法的协同过滤[2]。本文采用基于用户的推荐方法,最后实验表明改进后的方法比传统协同过滤算法更可靠。
二、传统协同过滤推荐算法
传统的协同过滤的一般过程是根据用户评分对用户进行相似度的计算,根据相似度找到用户的邻居用户,然后由邻居用户的喜好来预测评分进行推荐[3]。
用户相似度的计算是产生邻居用户并根据邻居用户进行个性化推荐的重要步骤,Person相似度算法是常用的相似度计算方法。设用户u和v共同评分过的物品集合为Iuv,则相似性sim(u,v)为: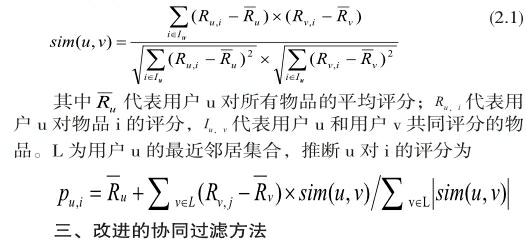
3.1相似度的修正
3.2引入信任度
传统的协同过滤算法在预测用户关于物品的评分时,只考虑了两个用户间的相似度,而忽视了该评分或该用户是否可信。景民昌等人提出“专家信任度”的概念[4],用来衡量用户向其他用户提供可靠信息的能力。……
登录APP查看全文
