基于Transfer-SVM多标签文本分类算法研究
2019-08-06 13:48:19李程文宋文广谭建平
无线互联科技
2019年10期
李程文 宋文广 谭建平
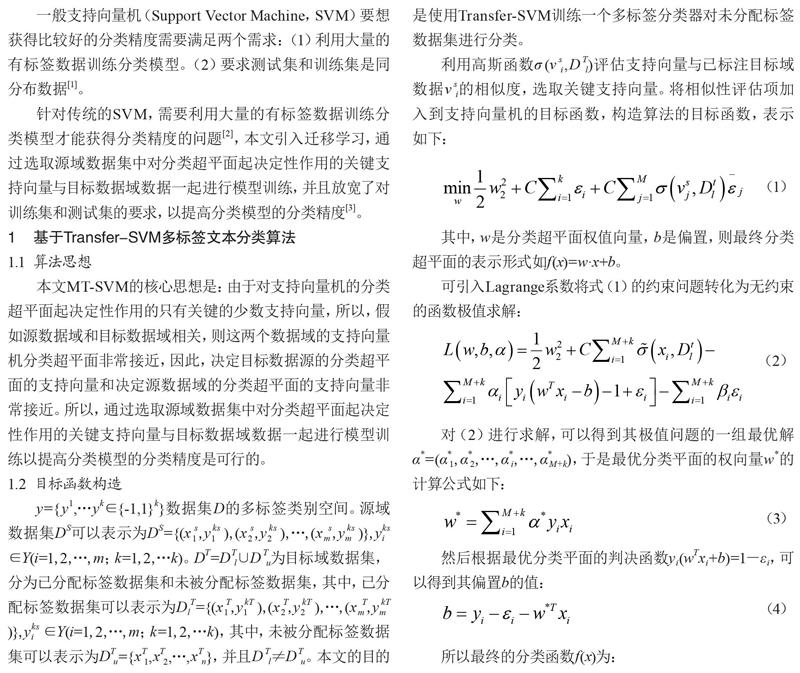
摘 要:传统的支持向量机分类模型只有在利用大量已标注数据进行训练才能获得较高精度。在实际应用中,多标签数据相对于传统单标签数据更具有价值,但多标签数据中含有大量冗余數据,获取大量多标签数据难度非常大。文章提出一种基于迁移学习的分类算法,利用目标数据域和源数据域的相关性,从源数据域中选取对分类超平面起关键作用的支持向量和目标数据域,一起训练分类模型以提高分类精度。
关键词:多标签;迁移学习;文本分类;支持向量机
一般支持向量机(Support Vector Machine,SVM)要想获得比较好的分类精度需要满足两个需求:(1)利用大量的有标签数据训练分类模型。(2)要求测试集和训练集是同分布数据[1]。
针对传统的SVM,需要利用大量的有标签数据训练分类模型才能获得分类精度的问题[2],本文引入迁移学习,通过选取源域数据集中对分类超平面起决定性作用的关键支持向量与目标数据域数据一起进行模型训练,并且放宽了对训练集和测试集的要求,以提高分类模型的分类精度[3]。
1 基于Transfer-SVM多标签文本分类算法
1.1 算法思想
本文MT-SVM的核心思想是:由于对支持向量机的分类超平面起决定性作用的只有关键的少数支持向量,所以,假如源数据域和目标数据域相关,则这两个数据域的支持向量机分类超平面非常接近,因此,决定目标数据源的分类超平面的支持向量和决定源数据域的分类超平面的支持向量非常接近。……
登录APP查看全文