规则引导的知识图谱联合嵌入方法
2021-01-05 03:05:02姚思雨赵天哲王瑞杰
计算机研究与发展
2020年12期
姚思雨 赵天哲 王瑞杰,3 刘 均
1(西安交通大学计算机科学与技术学院 西安 710049)
2(陕西省天地网技术重点实验室(西安交通大学) 西安 710049)
3(苏黎世大学计算机科学系 瑞士 8050)
近年来,由于具有表达能力强、歧义性低、模式统一、且支持推理等优点,知识图谱已被广泛用于组织和发布各领域的结构化数据.通常,知识图谱由实体、实体所具有的属性以及实体间的关系所组成.例如,其中可能包含有实体中国、关系首都以及实体属性“China”. 如图1所示,知识图谱的基础构成则是描述2个实体之间的关系或实体及其属性之间关系的三元组,如(中国,首都,北京)、(中国,英语标签,“China”).
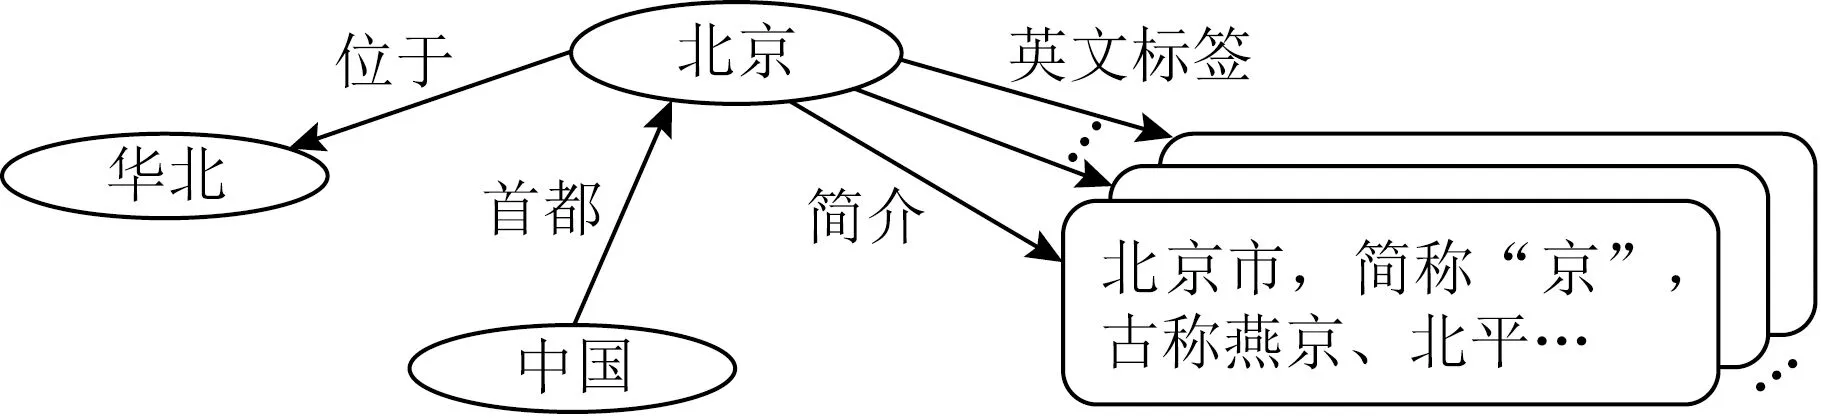
Fig. 1 Several triples which contain the entity Beijing and the related literals图1 包含实体“北京”的若干三元组及文本信息
目前,知识图谱已被广泛应用在智能问答[1]、推荐系统[2]和信息检索[3]等任务中,其突出表现在学术与工业界均获得了广泛关注[4].但是,受益于知识图谱所包含丰富信息的同时,其庞大的规模与数据稀疏性问题也给知识图谱的应用带来了挑战.例如,Freebase[5], Yago[6]和Dbpedia[7]等开放领域知识图谱中通常包含有数百万个实体,以及上亿条描述实体关系的三元组.将子图匹配等传统图算法应用在这些大规模知识图谱上往往存在计算低效性问题.为此,研究人员提出了知识图谱嵌入学习模型(knowledge graph embedding learning model),将知识图谱映射到低维、连续的向量空间中,学习实体与关系的嵌入表示[8].
通过设计特定的表示学习机制,知识图谱的结构和语义等信息可被编码在所学习到的嵌入表示中.一方……
登录APP查看全文
猜你喜欢
童话王国·奇妙逻辑推理(2024年5期)2024-06-19 16:03:38
数学物理学报(2020年2期)2020-06-02 11:29:24
制造技术与机床(2019年10期)2019-10-26 02:48:08
电子制作(2018年18期)2018-11-14 01:48:06
中华手工(2017年2期)2017-06-06 23:00:31
光学精密工程(2016年6期)2016-11-07 09:07:19
小学教学参考(2015年20期)2016-01-15 08:44:38
中外会展(2014年4期)2014-11-27 07:46:46
语文知识(2014年1期)2014-02-28 21:59:13
祝您健康(1987年3期)1987-12-30 09:52:32