藏文文本分类技术研究综述
2021-03-22 02:53:17苏慧婧群诺
电脑知识与技术
2021年4期
关键词:机器学习
苏慧婧 群诺
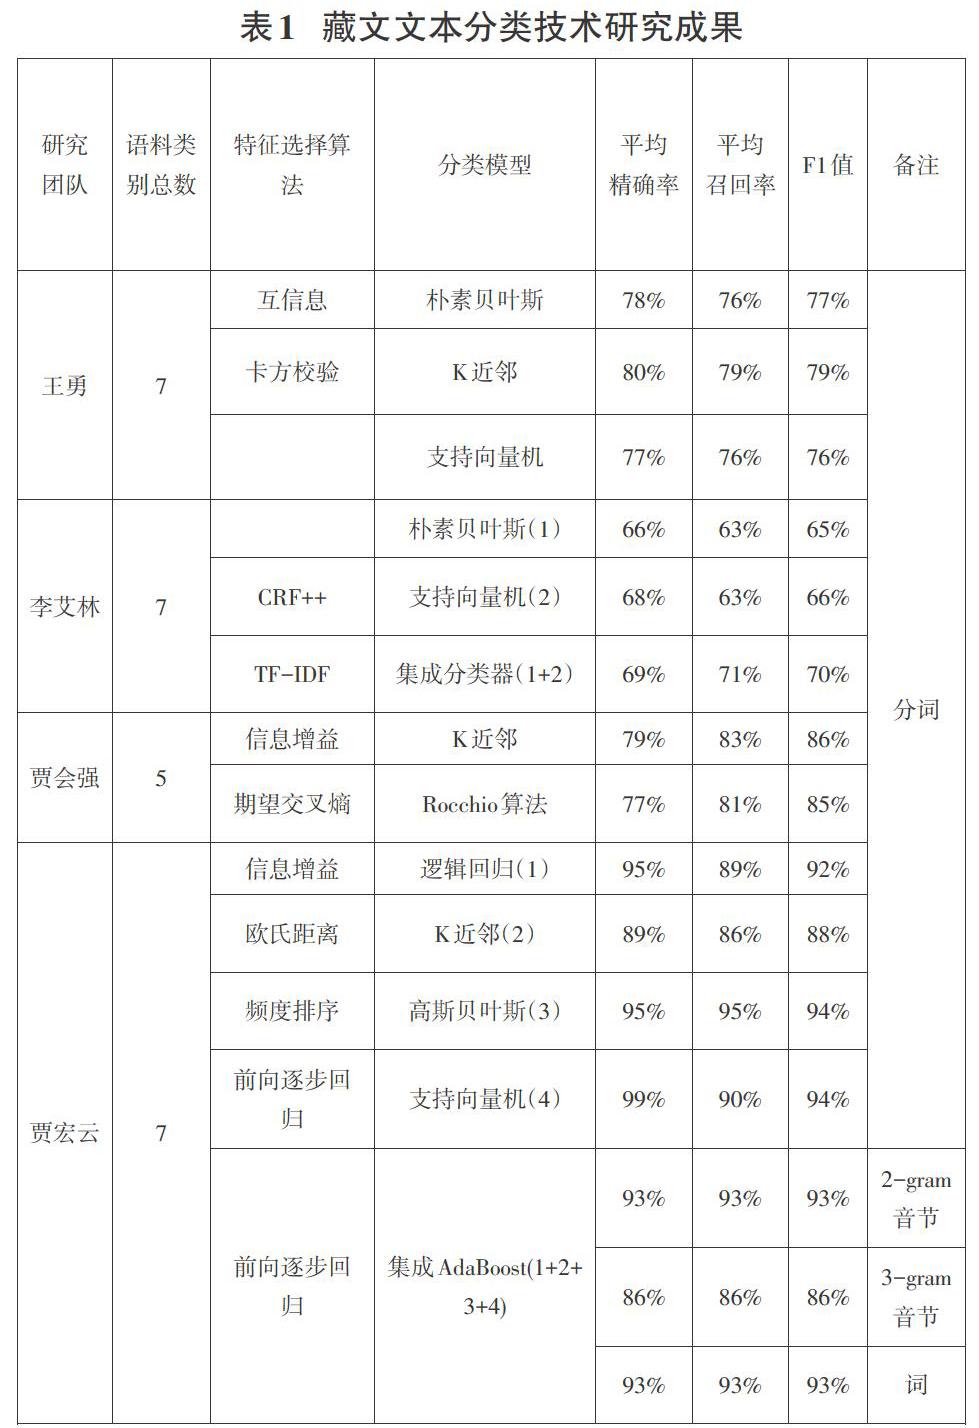

摘要:该文介绍了藏文文本分类技术的研究与进展。首先对现阶段常用的文本表示以及文本特征选择方法进行了分析和比较,接着回顾了藏文在机器学习方面的分类算法特点,深入讨论了不同算法应用在藏文文本分类技术上的研究情况,最后指出了当前藏文文本分类所面临的问题和挑战,并对未来的研究提出了建议。
关键词:藏文文本分类;文本表示;特征选择;机器学习
中图分类号: TP391 文献标识码:A
文章编号:1009-3044(2021)04-0190-03
Abstract :This article introduces the research and development of Tibetan text classification technology. First, it analyzes and compares the commonly used text representation and text feature selection methods at this stage, then reviews the characteristics of Tibetan classification algorithms in machine learning, and discusses the application of different algorithms in Tibetan text classification technology. Finally, it points out the current problems and challenges of Tibetan text classification, and puts forward suggestions for future research.
Key words :Tibetan text classification; text representation; feature selection; machine learning
自然語言是人们日常使用的语言,是人类学习生活的重要工具。为此,自然语言处理是人工智能的一个重要应用领域,也是新一代计算机必须研究的课题。随着我国藏族聚居区信息化事业的快速发展,藏族网民人数快速增长,以藏语为载体的内容也在增多。对藏文文本分类技术的研究,能够拓宽藏文信息处理的应用领域,推动藏文语言文学在网络时代的发展。文本特征的表示方法和分类器模型的设计是有关文本分类技术的关键步骤,本文简要提出了文本分类系统的各个功能,依据现阶段藏文文本分类技术的研究进展,详细分析了文本表示以及特征选择的不同方法和多种分类器模型的算法特点和应用前景。目前,我国对藏文古籍文献的经典信息需求量很大,因此,针对藏文文本,深入研究高效精准的文本分类技术,具有十分重要的现实价值和历史意义。
1 藏文文本分类研究现状和发展趋势
登录APP查看全文
猜你喜欢
电子技术与软件工程(2016年22期)2016-12-26 21:36:42
时代金融(2016年27期)2016-11-25 17:51:36
科教导刊(2016年26期)2016-11-15 20:19:33
活力(2016年8期)2016-11-12 17:30:08
科学与财富(2016年28期)2016-10-14 21:19:17
电脑知识与技术(2016年20期)2016-08-19 18:49:49
电脑知识与技术(2016年12期)2016-06-14 00:45:31
电脑知识与技术(2016年3期)2016-04-07 16:12:55
物联网技术(2015年9期)2015-09-22 09:23:43