基于语义距离的迁移学习算法在消费意图识别上的运用
2021-04-22 17:09:01彭达冯超
电脑知识与技术
2021年8期
彭达 冯超
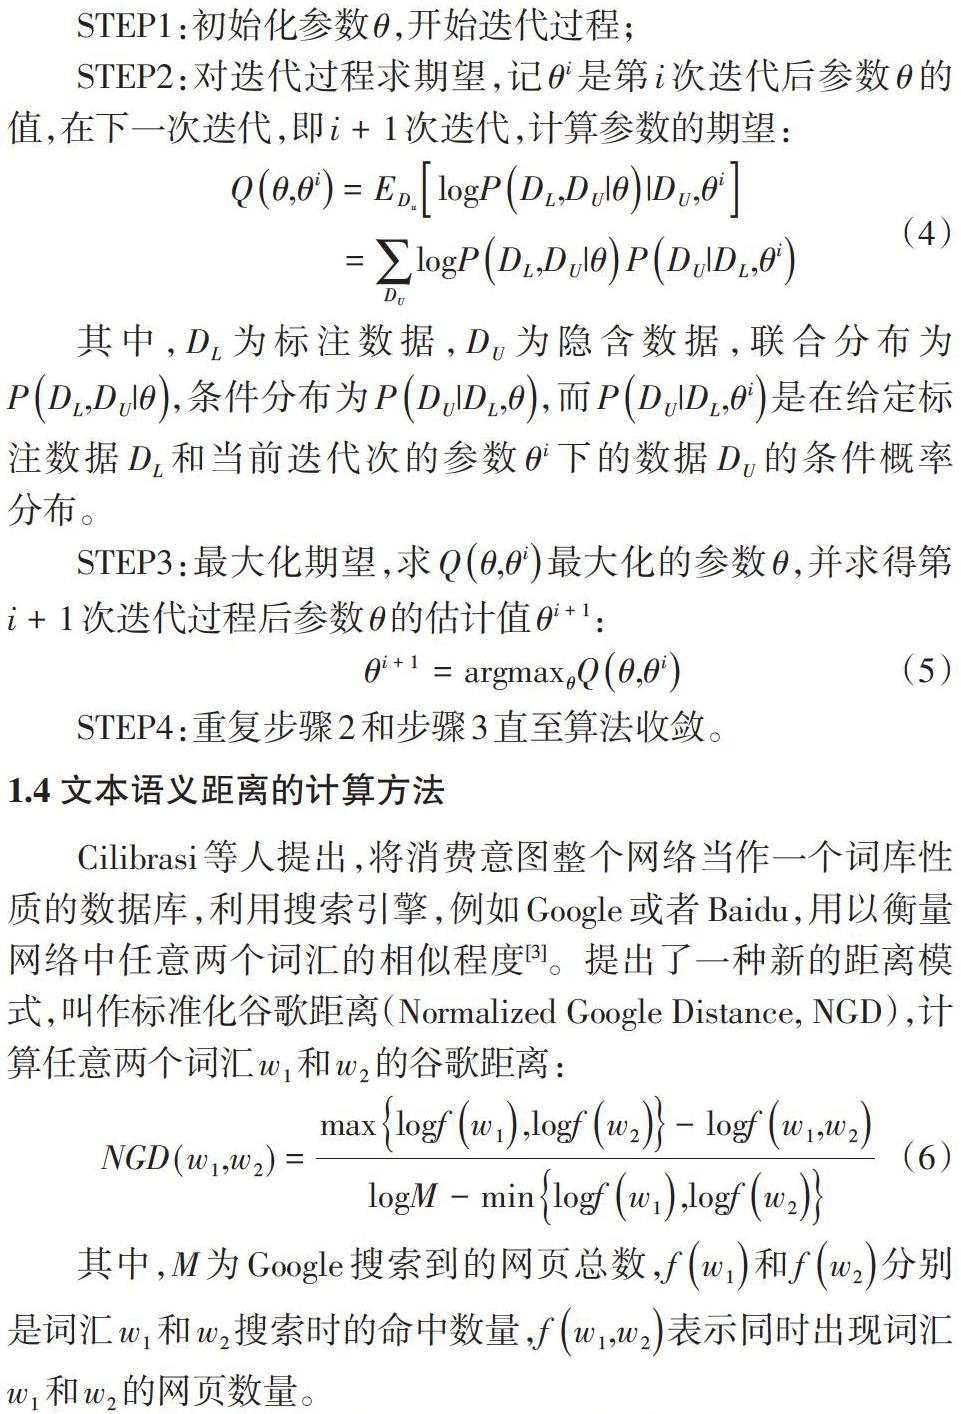

摘要:使用微博等短文本信息,识别判断用户的消费意图,对于电商以及数据分析者而言具有积极的意义。因此,借鉴Co-Class算法框架,借鉴微博特有特征信息,提出文本特征选择方法,设计语义距离计算方法,基于期望最大化算法(EM),使用SVM设计分类器,最终提出一种基于语义距离的迁移学习算法。通过实验,验证了算法的有效性,给出结论。
关键词:短文本;语义距离;迁移学习算法;消费意图
中图分类号:TP391.1 文献标识码:A
文章编号:1009-3044(2021)08-0210-02
随着微博、微信朋友圈,甚至运动软件等社交网络用户群的迅速增长,通过海量微博文本等短文本中识别某一用户是否具有消费意图,对于电子销售平台、信息分析公司或者大众消费者而言都有明显积极的意义[1]。由于微博等社交平臺的短文本限制,使用词袋模型表示会产生特征矩阵稀疏导致识别效率低下等问题。所以,研究跨领域中文短文本消费意图探测识别,设计基于语义距离的半监督统计方法,对数据建模,具有重要的意义。
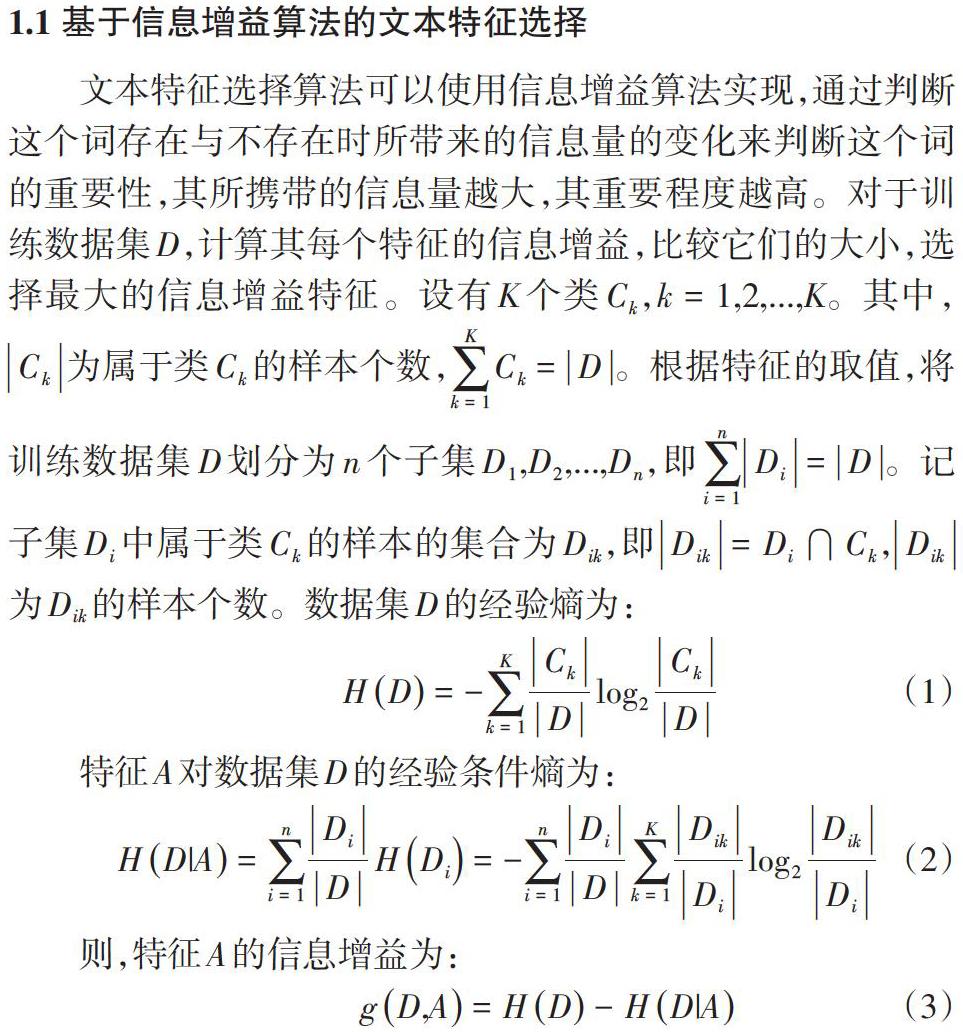
本文提出的基于语义距离的迁移学习算法主要工作可以分为以下几个步骤:文本预处理、特征的提取以及选择、语义距离计算、分类器的训练。其中文本预处理主要是切词、分词、转化标点符号以及去除明显错误,从而消除语料对于算法性能的影响,为算法的仿真实验做好铺垫工作。特征的提取以及选择是本文的一项主要工作,传统的迁移学习算法会丢失掉微博中标签等特征信息,降低了识别成功率,本文提出将微博中其他标签信息融入识别算法中,从而提升了算法的识别率。……
登录APP查看全文