基于图的多层次注意力事实验证算法
2021-05-26 03:13:20谢艺菲胡亚豪潘志松
计算机工程与应用
2021年10期
谢艺菲,卢 琪,刘 鑫,胡亚豪,潘志松,陈 浩
陆军工程大学 指挥控制工程学院,南京210001
随着社交媒体的兴起,网络上发布的内容都会接触到数万读者,这给互联网舆论监管带来巨大挑战。构建一个高效且自动化的模型来评估网络信息的真实性对于政府监管舆论导向具有重大研究价值。越来越多的研究者开始关注文本的事实验证(Fact Verification),该任务旨在从语料库中验证给定声明的真实性。
事实验证任务与文本蕴含(Textual Entailment)[1]和自然语言推理(Natural Language Inference)[2]不同,后两个任务都给定了验证声明的证据文本(通常是一个句子)。但在事实验证任务中,证据可能分散在不同的文章中,需要从庞大的语料库中检索。如图1 所示,给定一个声明,事实验证模型预测验证标签是“证实”“驳斥”或“信息不足”。
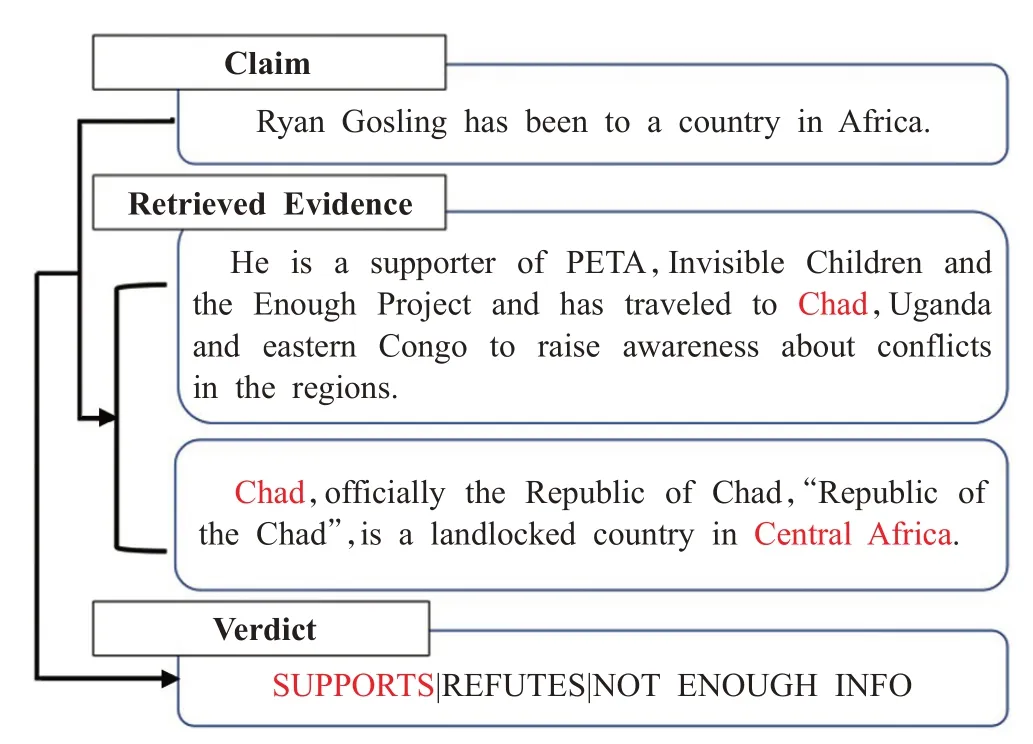
图1 事实验证数据样例
目前,BERT[3]、XL-Net[4]、Roberta[5]等预训练模型的出现,使得文本理解能力大大提升。虽然现有的模型近年来不断优化,但如何将这些强大的编码器应用到具体任务中,仍然是待解决的问题。首先,在事实验证任务中细粒度语义辨析至关重要,因为即使声明的语义和语法都正确,但个别词语替换,就会使得声明与事实背离。其次,在仅靠单句单文本无法验证的场景中,现有模型仍缺乏跨句子跨文本的推理能力。当前一些研究将所有检索出的证据简单拼接,但是忽略了细粒度语义的辨析以及分散的证据之间的关系,这些对于理解证据的关系结构和推理过程是至关重要的。
针对事……
登录APP查看全文
猜你喜欢
童话王国·奇妙逻辑推理(2024年5期)2024-06-19 16:03:38
数学物理学报(2020年2期)2020-06-02 11:29:24
开放教育研究(2020年2期)2020-03-31 01:54:14
中华手工(2017年2期)2017-06-06 23:00:31
光学精密工程(2016年6期)2016-11-07 09:07:19
现代语文(2016年21期)2016-05-25 13:13:44
大连民族大学学报(2015年2期)2015-02-27 08:28:11
中外会展(2014年4期)2014-11-27 07:46:46
外语学刊(2011年1期)2011-01-22 03:38:33
祝您健康(1987年3期)1987-12-30 09:52:32