
基于Web的数据挖掘模型研究
2021-12-24 04:30:56蒲道北
中国新通信
2021年19期
蒲道北

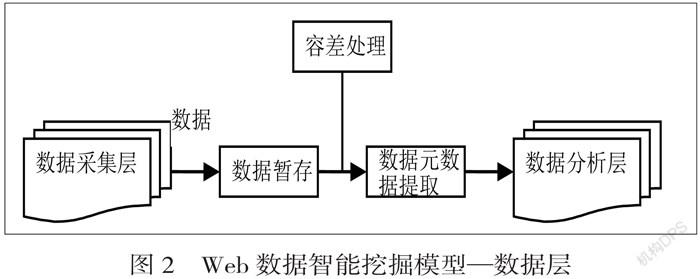
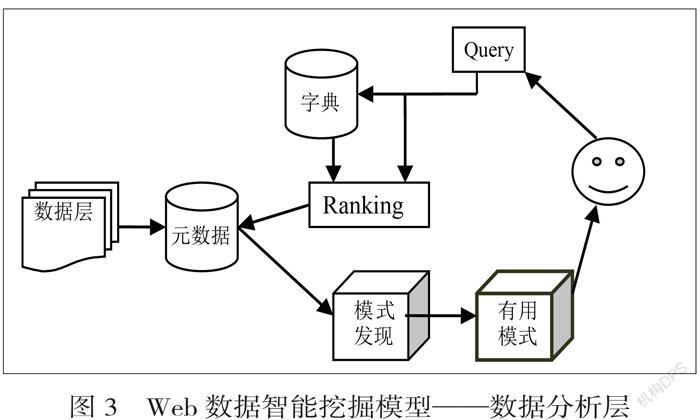


【摘要】 从海量、复杂的Web数据中获取有价值的信息一直以来都是互联网研究的热点,本文在基于Web数据挖掘的研究中,优化出一种新的面向Web的数据挖掘模型,该模型利用Robot程序采集到的Web数据与特征信息进行匹配规范,然后在数据层中进行容差处理,调整差值数据,最终通过模式分析得到有用信息。实验结果表明,利用提出的模型对Web数据的挖掘结果质量上有了明显的改善和提升。
【关键词】 Web数据 数据挖掘 模型 数据智能
引言:
Web有着分布广泛的、全球性的信息,成为人们获取信息的主要渠道。然而如何在Web上搜索找到适合它使用者兴趣的信息呢?目前,人们主要通过3中主要方式查找:1.使用基于关键字或主路径浏览的搜索引擎,如百度或Google,它们通过使用关键字索引或人工建立路径来查找文档;2.查询深度Web资源。如amazon.com的书籍数据和realtor.com的固定资产数据;3.随机访问,通过网页链接一页一页浏览[1-2]。尽管基于关键字、IP地址和主题的搜索引擎支持Web信息搜索,但还存在着返回结果太多、查询质量低、查询覆盖面小、缺乏多维分析和数据挖掘支持等缺点。为了克服以上缺点,业界提出将数据挖掘技术应用在Web数据上,并形成一个新的研究方向,本文就现有的web数据挖掘技术基础上优化出一种新的Web数据挖掘的模型,该模型充分利用了XML的优点,采用Robot程序采集Web中的有用数据,并将得到的数据与特征信息进行匹配,匹配成功后在数据层中进行数据容差处理,调整差值数据,得到数据模式,通过模式分析最终得到有用数据。……
登录APP查看全文
猜你喜欢
童话王国·奇妙逻辑推理(2024年5期)2024-06-19 16:03:38
大众投资指南(2021年35期)2021-02-16 01:06:26
数学物理学报(2020年2期)2020-06-02 11:29:24
电力与能源(2017年6期)2017-05-14 06:19:37
中国中医药信息杂志(2016年7期)2016-12-01 06:07:55
光学精密工程(2016年6期)2016-11-07 09:07:19
信息通信技术(2015年6期)2015-12-26 01:16:46
核科学与工程(2015年4期)2015-09-26 11:59:03
河南科技(2014年23期)2014-02-27 14:18:43
电子设计工程(2014年18期)2014-02-27 12:00:13
