基于Spark的大数据计算模型
2016-08-19 18:49:49王磊时亚文
电脑知识与技术
2016年20期
关键词:机器学习
王磊++时亚文
摘要:作为第三代机器学习工具,spark被视为替换Hadoop的下一代数据处理解决方案.包括了迭代计算、批处理计算、内存计算、流式计算、数据查询分析计算及图计算,提供了强大的内存计算引擎.Spark有望成为下一代大数据热门框架.研究分析了Spark组件生态圈和Lambda架构.最后介绍了Spark应用于机器学习领域.
关键词:机器学习;spark;Hadoop
中图分类号:TP301 文献标识码:A 文章编号:1009-3044(2016)20-0007-02
Abstract:As the third generation of machine learning tools, spark is considered as the next generation of data processing solution to replace Hadoop, including the iterative calculation, batch calculation, memory computing, flow calculation, data query analysis and graph calculation. It provides a powerful memory computing engine.Spark, which is the next generation of big data popular framework.
Key words:Machine learning; spark; Hadoop
大数据通常分为批量数据流及实时数据流。两种流类型都有各自解决方案,前者通常采用MPI、OpenMP及Hadoop等并行模型进行集群计算,后者采用流数据模型进行处理,如
Storm、S4及Spark Streaming。IBM研究院Sun[1]等认为MapReduce计算模型在倒排索引、kNN分类等批量处理的数据挖掘或统计机器学习算法中有较好效果,K-Means、高斯混合、PageRank、LDA等需要多次迭代的算法用MapReduce模型也有较好效果,缺陷是MapReduce计算模型在大量数据同步的算法如SVM中效果不佳,因此Spark集群计算平台应运而生。
1 Spark模型介绍[2]
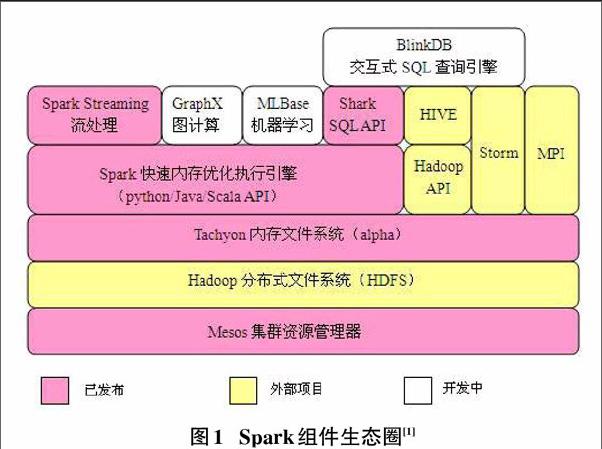
Spark是UC Berkeley AMP lab开发的开源集群计算平台,是以内存计算为基础的集群计算框架。Hadoop模型中的MapReduce模式的缺陷是运行速度慢,比较适合离线的任务分解,运行程序时需要复制额外的信息,序列化和磁盘I/0所带来的时间空间开销代价也比较大,Spark模型基于内存计算而且执行作业是基于构建的Stage有向无环图,Spark模型运行速度快的主要原因是算子融合和有向无环图,Spark模型设计和内核处理模式较适合进行大规模信息处理。Spark组件生态圈如图1。
2 Spark在RDD中的编程模型[3,5]
RDD(Resilient Distributed Datasets)弹性分布式数据集是分布式内存的一个抽象概念,RDD设计了一种高度受限的共享内存模型,通过在其他弹性分布式数据集执行确定的转换操作而创建,这些限制使得容错实现的开销代价降低。……
登录APP查看全文
猜你喜欢
电子技术与软件工程(2016年22期)2016-12-26 21:36:42
时代金融(2016年27期)2016-11-25 17:51:36
科教导刊(2016年26期)2016-11-15 20:19:33
活力(2016年8期)2016-11-12 17:30:08
科学与财富(2016年28期)2016-10-14 21:19:17
电脑知识与技术(2016年12期)2016-06-14 00:45:31
电脑知识与技术(2016年3期)2016-04-07 16:12:55
物联网技术(2015年9期)2015-09-22 09:23:43
科教导刊(2015年19期)2015-08-05 16:55:27