基于半监督学习的命名实体识别的方法
2020-04-21 07:40:59刘一鸣
数字技术与应用
2020年1期
刘一鸣
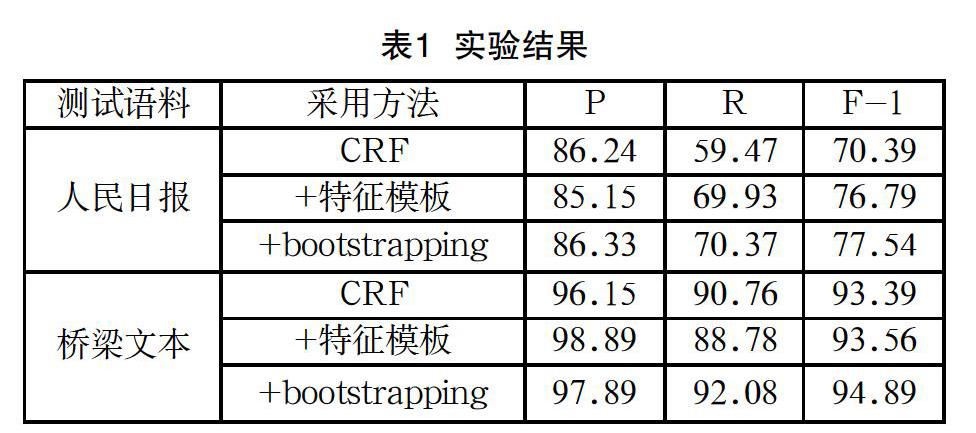

摘要:命名实体识别是信息抽取中基础且关键的一项子任务。本文根据不同领域文本的特性,设置了通用的特征模板,利用半监督学习的方法,对新闻文本和桥梁文本分别进行了命名实体识别。实验表明,仅使用少量标注的语料也可以达到较好的识别效果。
关键词:命名实体识别;自学习方法;半监督学习
中图分类号:TP391.4 文献标识码:A 文章编号:1007-9416(2020)01-0207-02
命名实体识别概述
随着信息技术的发展,网络数据出现飞速增长的趋势,并呈现出多源异构等大数据特征。对其进行信息抽取,获得有效信息对于文本数据分析具有重要的研究意义。
命名实体识别是信息抽取过程中十分基础且关键的一项子任务。命名实体识别是指识别出文本中例如人名,地名,时间或组织名等具有特定意义的实体。
大多数命名实体识别的方法都是基于规则[1]的方法或基于监督学习[2]的方法。其中基于规则的方法需要专业人员去设置规则模板,但是规则之间可能会出现冲突,且可移植性和扩展性差。基于监督学习的方法十分依靠大量的标注文本,在通常情况下标注文本是极难获取的,且使用人工标注的成本較大。因此,只需要少量标注语料的基于半监督学习的命名实体识别方法成为了领域内研究的热门。
2 研究现状
命名实体识别一直是自然语言处理领域研究的基础性问题,其本质可看作序列化数据标记问题[3]。
早期的命名实体方法是在限定文本领域、限定语义单元类型的条件下进行的,采用的是基于规则与词典的方法。……
登录APP查看全文